문제
두 편집기를 연결해도 저장의 기준은 하나여야 함
사람과 AI가 같은 XLSX를 편집하는 로컬 작업 공간을 개인 프로젝트로 만들었습니다. 제품 설계부터 Go XLSX adapter, MCP 전송, Univer 편집기와 복구 모델까지 독립적으로 구현한 XLSX 알파입니다.
사용자와 AI가 revision 12의 문서를 읽고 각각 변경하면, 마지막에 도착한 요청을 그대로 덮어쓰는 방식은 먼저 반영한 변경을 잃게 만듭니다. 저장은 성공했는데 응답만 유실된 상황도 문제입니다. 행 삽입을 자동 재시도하면 같은 행을 두 번 만들 수 있고, 서버 revision이 올라갔다는 사실만으로는 내 요청이 성공했는지 알 수 없습니다.
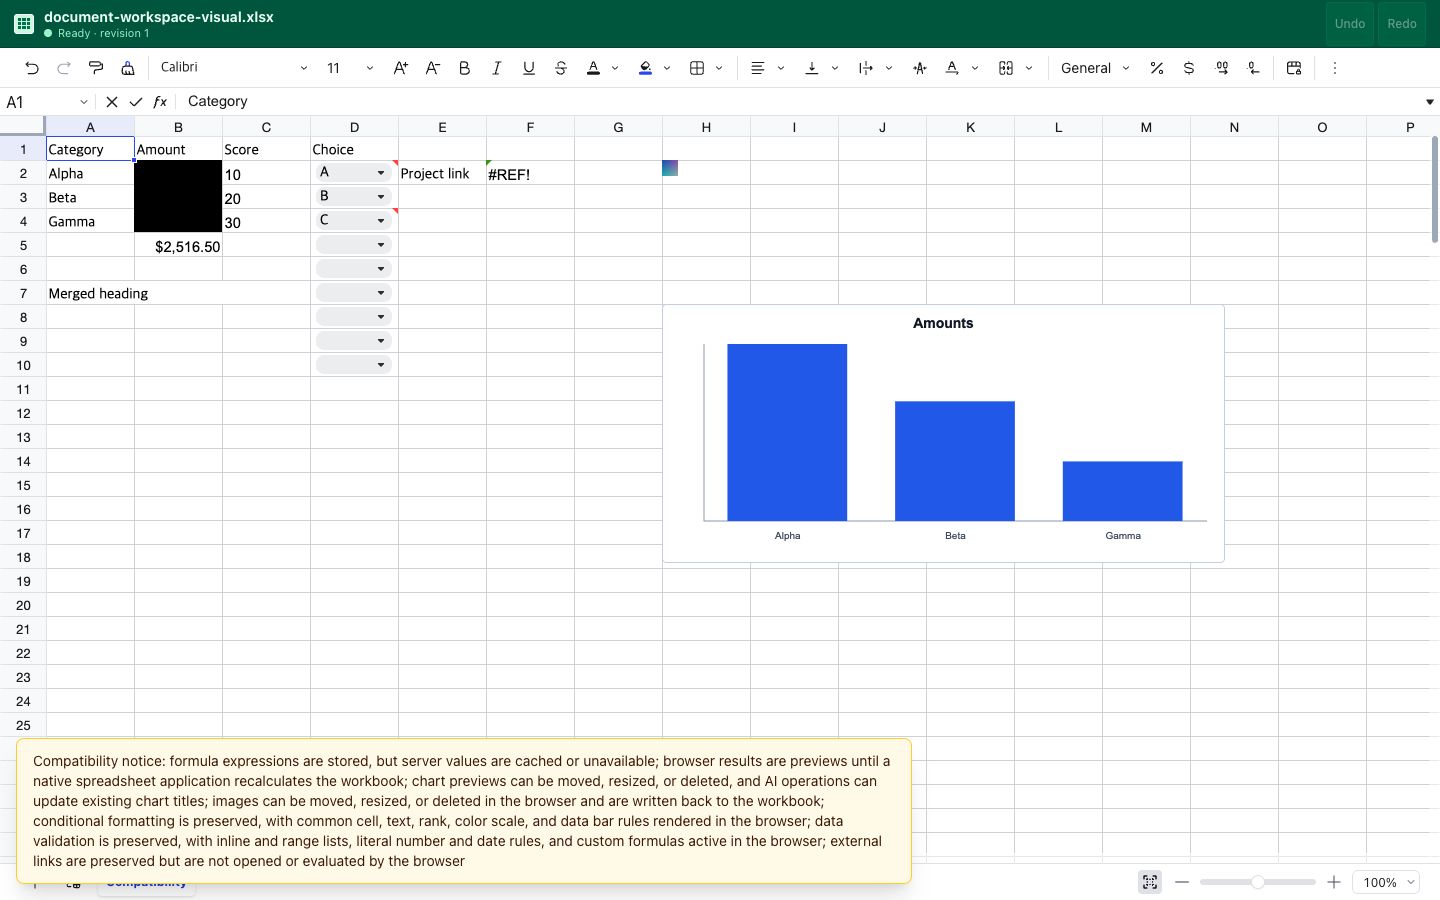
XLSX 저장에는 별도의 보존 문제가 있습니다. 셀 값 하나를 바꿨는데 기존 수식, 유효성 검사나 차트가 사라지면 편집기는 정상처럼 보여도 원본은 훼손됩니다. 화면 엔진의 데이터와 저장할 문서의 원본 상태를 같다고 가정할 수 없었습니다.
선택한 방법
1. 화면 엔진과 문서 원본의 책임 분리
엔진 결정 문서에서는 Univer, ONLYOFFICE와 자체 구현을 비교했습니다. 직접 그리드를 만들면 선택, 키보드, clipboard와 수식 UI까지 유지해야 합니다. ONLYOFFICE는 편집 기능이 넓지만 MCP App에 포함할 때 중첩 frame과 배포 조건을 검토해야 했습니다. 셀·범위 작업을 코드로 제어하고 앱 안에 직접 포함할 수 있는 Univer OSS를 UI 엔진으로 선택했습니다.
대신 Univer를 XLSX 원본의 저장 주체로 두지 않았습니다. SpreadsheetEngine 경계 뒤에서 렌더링과 입력을 담당하게 하고, Go adapter가 검증된 작업, revision, 충돌과 저장을 소유합니다. 편집기 엔진을 바꿔도 문서 저장 규칙을 다시 작성하지 않도록 한 경계입니다. 고급 기능의 표시와 원본 보존을 직접 연결하고 검증해야 한다는 비용은 남습니다.
2. 동시 쓰기는 병합을 추측하지 않고 충돌로 반환
브라우저와 AI의 변경은 actor, base revision과 작업 목록을 포함해 같은 commit 경로로 들어옵니다. 예를 들어 두 요청이 revision 12에서 시작하면 먼저 저장한 요청만 13으로 진행하고, 뒤 요청은 최신 revision을 포함한 conflict로 반환합니다. 한 batch 안의 일부 작업만 먼저 반영하지 않도록 전체 검증 후 candidate 문서에 적용합니다.
셀 값뿐 아니라 행·열 삽입과 병합 같은 구조 변경이 있으므로, stale 작업을 자동으로 최신 문서에 다시 적용하지 않았습니다. 현재 구조는 서로 다른 위치의 동시 수정도 충돌할 수 있다는 비용을 감수하는 대신, 어떤 상태를 기준으로 변경했는지 명확하게 유지합니다. 세밀한 자동 병합은 별도의 의미 규칙이 필요한 후속 과제입니다.
3. 저장 실패와 응답 유실을 다른 문제로 처리
변경은 candidate workbook에서 준비하고 같은 디렉터리의 임시 파일에 기록한 뒤 원자적으로 교체합니다. 준비, write, sync, close나 replacement가 실패하면 기존 revision과 기준 메모리 상태를 유지합니다. 문서 교체는 끝났지만 history manifest 확정만 실패한 경우에는 pending 상태를 남겨 다음 쓰기 전에 조정합니다.
응답 유실은 무작정 쓰기를 다시 보내서 해결하지 않습니다. 브라우저 controller는 쓰기 queue를 멈추고 서버 snapshot을 확인하며, 초안과 복구 상태를 보여줍니다. SSE의 event gap이나 session 불일치도 재동기화로 전환합니다. 높은 revision을 봤다는 이유로 특정 요청의 성공을 추측하지 않는 원칙을 적용했습니다.
외부 프로그램의 파일 교체는 source hash와 협조 writer용 잠금으로 감지합니다. 다만 비협조 프로그램이 마지막 검사와 교체 사이에 쓰는 경쟁까지 없애는 구조는 아닙니다. 로컬 원자적 교체와 모든 외부 writer를 제어하는 보장은 구분했습니다.
4. Undo도 서버가 저장하는 새로운 변경으로 관리
Undo와 redo는 브라우저의 임시 기록이 아니라 서버의 revisioned history입니다. 과거 내용을 복원해도 revision 숫자를 되돌리지 않고 새로운 revision을 만듭니다. 그래야 이전 revision에서 시작한 요청이 복원 이후의 상태를 같은 문서로 오인하지 않습니다.
최근 snapshot과 manifest를 디스크에 보관해 재시작 이후에도 제한된 이력을 복구합니다. 큰 snapshot을 무제한으로 쌓지 않도록 보관 개수와 크기에 상한을 두며, 이력을 보관할 수 없는 경우와 문서 commit 자체가 실패한 경우를 구분합니다.
5. 큰 문서는 범위로 읽고, 다른 형식은 독립적으로 확장
Univer 편집기는 viewport에 필요한 제한 범위부터 읽고 스크롤에 따라 추가 범위를 불러옵니다. MCP도 전체 workbook을 매번 전달하는 대신 metadata와 필요한 범위를 읽도록 구성했습니다. 브라우저와 MCP 인증 정보는 분리하고, 대체 브라우저 URL은 한 번만 사용하며 2분 뒤 만료되게 했습니다.
XLSX의 형식 규칙은 adapter에 둡니다. DOCX·PPTX·PDF도 같은 모델에 바로 끼워 넣기보다, 두 번째 실제 adapter에서 공통 계약이 확인된 뒤 추상화하도록 정했습니다. 수식은 저장하지만 서버가 계산하지 않고, 브라우저 계산 결과도 원본의 계산값과 구분합니다.
확인한 결과
실패 조건을 자동 검사로 남김
2026-10-12의 안전성 기록에는 다음 gate가 통과한 것으로 남아 있습니다. Go 집중 검사는 race detector를 사용했고, 브라우저 복구와 history 상태는 별도 검사로 확인했습니다.
- 입력과 원자성: OOXML 경계, 잘못된 batch의 부분 변경 방지, 같은 revision의 동시 쓰기 중 정확히 하나만 commit.
- 저장과 외부 변경: 저장 단계별 실패 시 원본 보존, pending history 조정, 외부 교체와 stale session 거절.
- 연결과 복구: event replay gap, 느린 구독자, 응답 유실 뒤 구조 변경의 중복 적용 방지, session 불일치 재동기화.
- 영속 이력: undo·redo 복원, 재시작 뒤 이력 복구, 보관 한도 이후에도 revision의 단조 증가.
40만 셀 workbook의 성능 기록
같은 날의 성능 기록은 darwin/arm64, Go 1.25.0, Excelize 2.11.0 환경에서 생성한 4개 시트·40만 셀 workbook을 사용했습니다. 세션 열기 757.79ms, 10,000셀 읽기 7.81ms, 1셀 commit 336.87ms, 1,000셀 commit 287.74ms가 기록되어 있습니다.
이 값은 2026-10-12에 동일한 합성 workbook과 환경에서 기록한 결과입니다. 해당 workload를 릴리즈 회귀 기준으로 사용합니다.
이 프로젝트에서 구현한 것은 사람과 AI의 입력 화면뿐 아니라 충돌, 저장, 이력과 복구가 같은 서버 상태를 기준으로 동작하는 편집 경로입니다. 기능 확장보다 원본을 지키는 경계와 실패 이후의 동작을 먼저 명시한 설계 경험입니다.
근거
- 400K cells
- release profile workbook4 sheets · 1000 by 100
- 287.74 ms
- 1,000-cell batch commitdarwin-arm64 · Go 1.25
- X-01 to X-06
- automated safety gatesatomicity · recovery · history